みなさん、こんにちは。
カバー株式会社CTO室のK・Mです。
AIエンジニアとして、機械学習に関連した技術の開発や関連する最新技術・プロダクトの検証などを担当しています。
はじめに
タレントの皆さんが自然に振る舞うためには様々な技術が用いられます。その代表的なものがトラッキング技術です。トラッキング技術については、過去の記事で解説しています。あわせてご覧ください。


これらの記事では、カメラやセンサ付きのデバイスを用いた事例が紹介されています。しかしながら、これらが利用できない環境もあります。また、別のアプローチによるアニメーション操作が求められる場合もあります。
そこで今回は、音声入力に基づく表現技術について解説します。
リアルタイムリップシンク
「リップシンク」という言葉を聞いたことがありますでしょうか。
ここでは、アバターの口の動きと発せられる音声を連動させることを指します。
一般に映像コンテンツでリップシンク技術を取り扱う場合に、音声を入力データとして扱い、その内容を解析し、結果に応じた口のアニメーションを再生するという方法で実現されています。
この際、事前に決まったセリフがあり、またその音声データが個別のファイルとなっている場合は、発せられる言葉と収録された音声の系列情報によって高品質な音素推定や口形素推定が可能であったりします。
一方で、当社のようにリアルタイムのライブ配信を行う場合、前述のような方法では都合が悪いことが多いです。リアルタイムで音声を入力として受け取り、その場で処理する必要があります。
これを実現可能にするUnity上で動作するよく知られているライブラリがいくつか存在します。しかし、それらでは演者毎の個別なチューニングが必要であったり、一部の日本語や特徴的な音声(ロングトーンなど)を極端に苦手にするなど課題がありました。
このような背景の元、カバー株式会社では内製のリップシンク技術を開発し、2024年7月末頃から3D配信・動画で徐々に利用されはじめています*1(図1)。
この投稿の前半では、カバーのリップシンク技術の実装や課題感などについて記したいと思います。
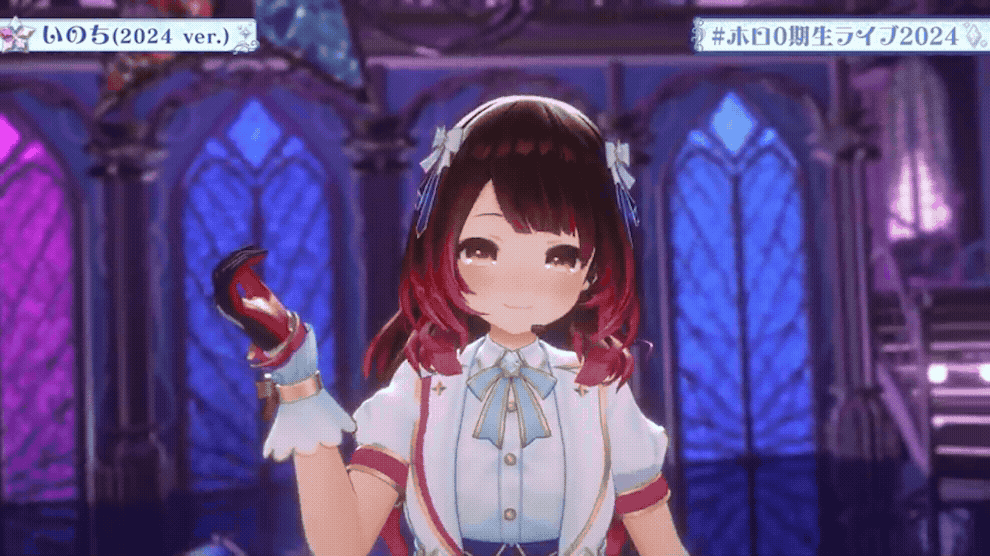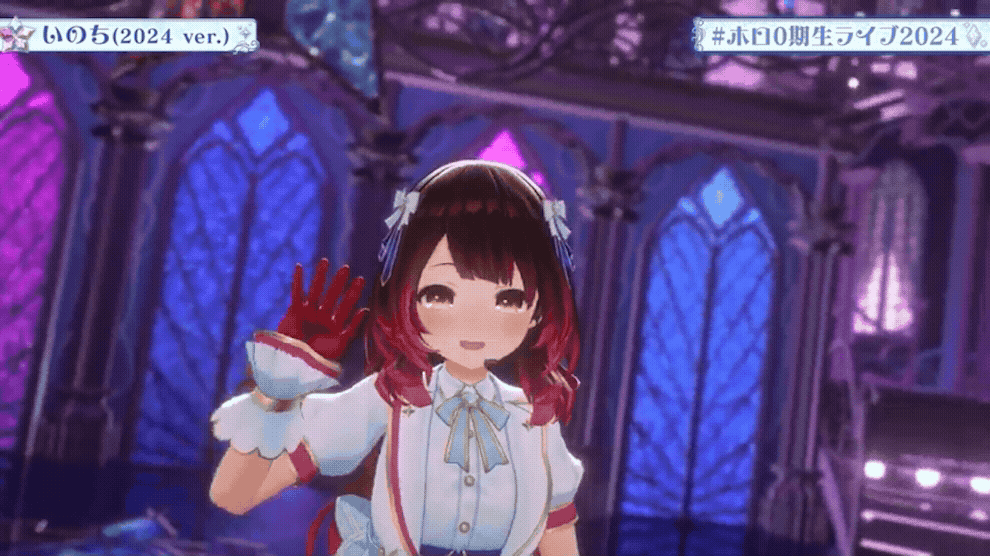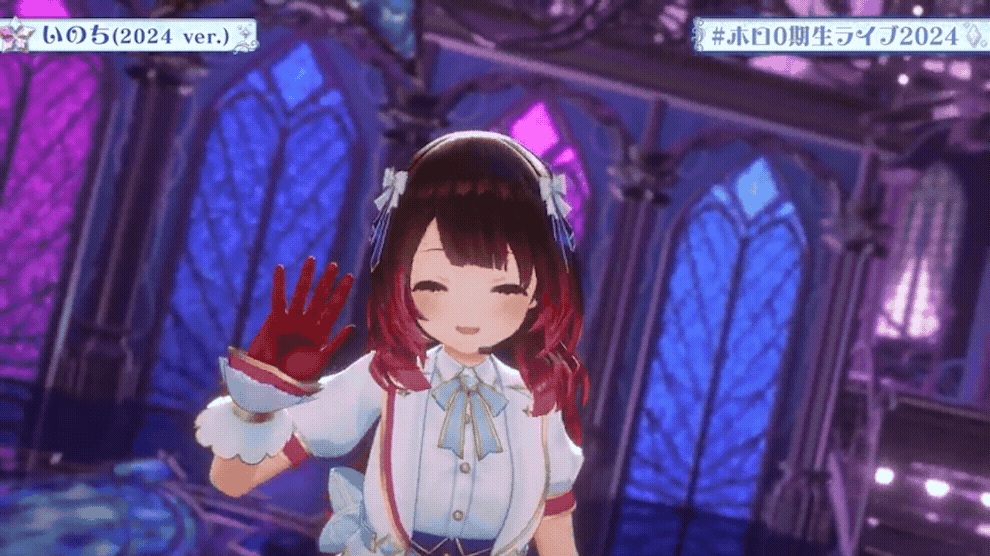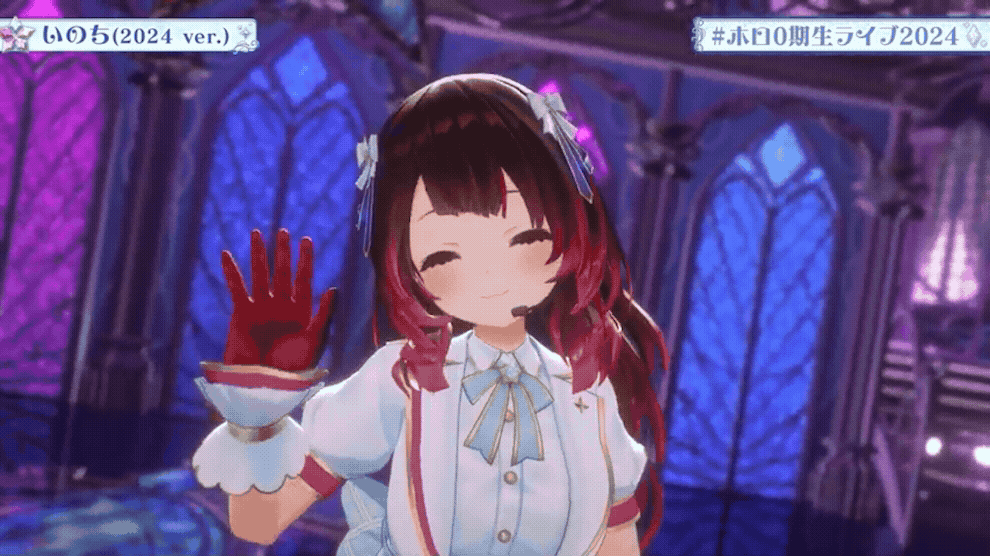
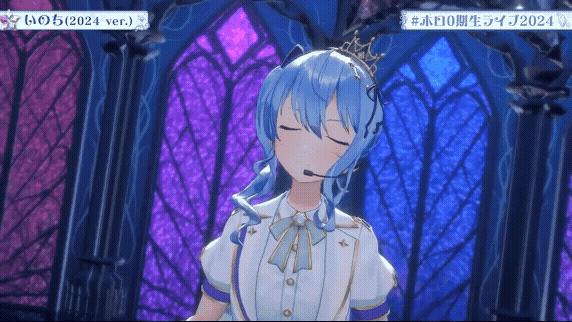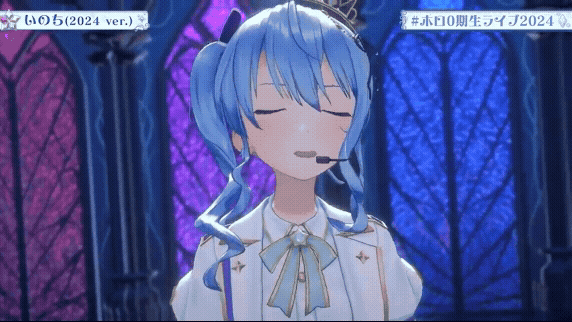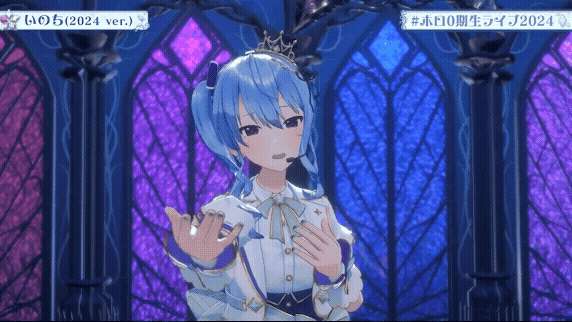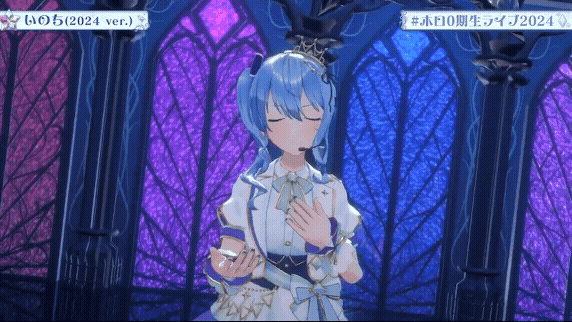
【3D LIVE】Ray of Jewelry【#ホロ0期生ライブ2024】
*1 この日時以降に公開されたすべての配信・動画で使われているわけではありません。
開発
出力情報
今回最終的に出力したい情報は、認識された音声に対応する口の動きを決めるための分類結果です。必ずしも細かな音素をそのまま高精度に推定することが目的ではなく、現在の3D配信で利用されるモデルにおいて、自然に見える口形制御へつなげられることを重視しました。
日本語の発話は多様な音素から成りますが、現在の3D配信で利用される3Dモデルには主に /a/, /i/, /u/, /e/, /o/ に対応するBlendshape(表情などの形状変形を定義する仕組み)が用意されています。一方で、口を閉じる必要がある音や「ん」のような撥音・鼻音も無視できません。そこで今回は、[/a/] [/i/] [/u/] [/e/] [/o/] [鼻音・破裂音] [その他の子音] の合計7クラスへの分類結果を出力しました。離散的な分類結果をもとに、時系列の変化は音量に関するデータと合わせ、描画側で補間します。
データセット
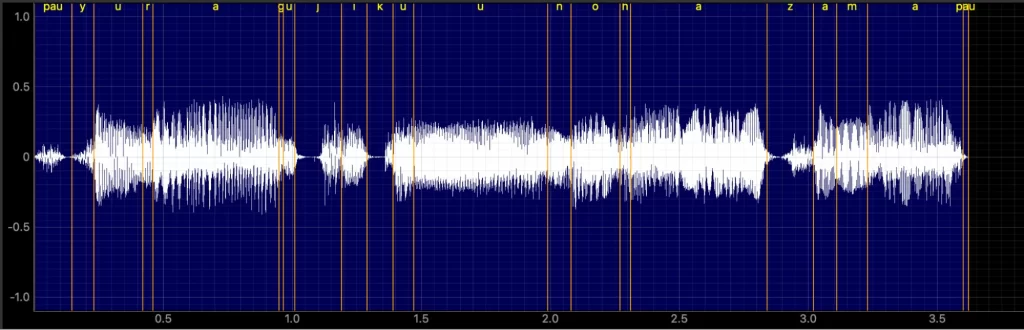
前述の内容から今回は音声(系列データ)を入力し、それを7つのクラスに分類する課題であるということがわかります。利用を想定する学習用データは、音声データとその音素アラインメントです。ツールとしてはJuliusが有名かと思います。
当社でデータを用意するときは、pydomino*2を使用しています。以前に技術ブログを書かれているTさんに協力をいただきながら音声データとテキストデータを元に、アラインメントされたデータを独自で用意するツールも作成しています(図2)。これを用いて、必要な追加データを用意して、学習モデルを作成・アップデートしています。このように継続的にデータを整備できることは、モデル自体の改善に加えて、実運用で見つかった課題へ追従していく上でも重要です。
*2 https://github.com/DwangoMediaVillage/pydomino
学習方法
最近の合成音声を中心とする研究領域では、自己教師あり学習が増えてきた印象ではありますが、今回は典型的な教師あり学習を行うこととなります。
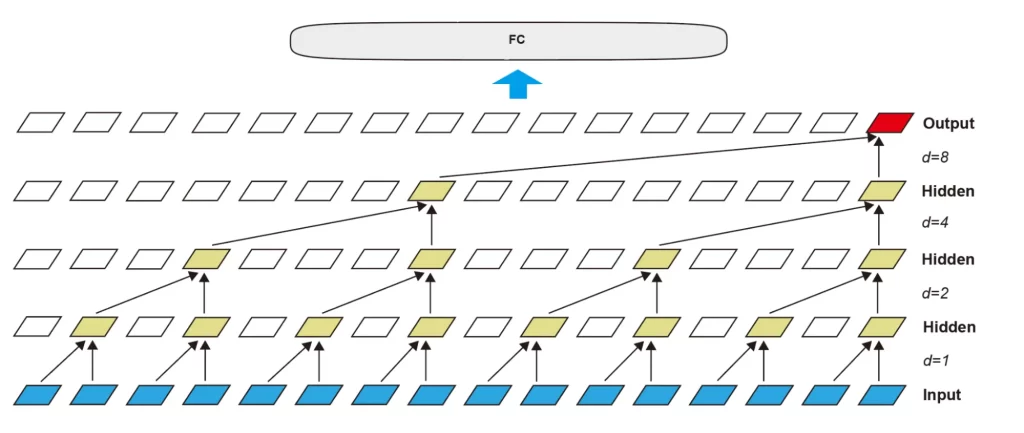
系列データを扱う手法としては、RNNやLSTM、Transformerなどさまざまな選択肢があります。今回重視したのは、理論上の最高性能そのものよりも、ライブ用途で安定して扱えることでした。具体的には、低遅延であること、計算資源を過度に消費しないこと、限られたデータ量でも扱いやすいこと、そして複数人同時利用を含む実運用に載せやすいことです。そこで今回は、Convolutionベースで系列データを学習する手法を採用することとしました。Temporal Convolutional Network (TCN) と呼ばれる手法で、軽量かつ高速であり、リアルタイムのリップシンクとの相性も期待できます(図3)。
開発当初のパラメータ数は9K未満(13KMACs)で、モデルサイズも320KB程度に収まるほど軽量なモデルでした。最新版ではスループットへの影響がないことを確認し、6M程度までパラメータ数を増やし、モデルの表現力と精度向上を図っています。
TCNに入力する音声情報については、音声そのものをそのまま扱うのではなく、口の動きと関係しやすい特徴量へ変換して利用します。この部分は今回の開発の中でも特に時間を割いた箇所であり、どの特徴量を用い、どの程度の時間幅を見れば、低遅延と十分な精度を両立できるかを慎重に検討しました。
音声認識などの領域ではMFCC(メル周波数ケプストラム係数)が用いられることが多いです [1]。その他には、話者識別などにフォルマントを用いたりする場合もあります。MFCCは人の聴覚特性に合わせたフィルタで信号を変換したものです。この特徴量自体はlibrosa*3などの音声処理ライブラリを用いることで非常に簡単に算出することができます(ただし今回のように高速で何回も計算するような場合にはライブラリに実装されている関数をそのまま利用するのは計算量の観点で適切ではありません)。リップシンクについてはMFCCとフォルマントどちらも使われることがありますが、話者依存を抑えるために今回はMFCCを中心に用いることとしました。ここで重視したのは、音声を細かく言語的に解析することそのものではなく、話者差に過度に引っ張られず、口形制御に安定してつながる特徴を得ることです。
さらにはバッファサイズやウィンドウサイズなどの慎重な検討が求められます。現在時刻から20msの情報に直前の80msの情報を加えた特徴量を用いることとしました。つまりは音が発せられた後の20msまでの情報を聞いており、処理時間などを無視した場合の遅延は20msとなります。ここの数値は遅延と精度とのトレードオフであり、遅延を許容し、より多くの情報を入力として利用できれば精度向上が期待できるかと思います。
*3 https://librosa.org/doc/latest/index.html
パフォーマンス・パラメータ調整
ここまでの内容で実装したシステムのパフォーマンスについて考察します。なお、この課題では分類タスクとしての精度と、視聴時に感じられる自然さが必ずしも一致しません。そのため、評価においては数値上の性能だけでなく、実際の映像としてどのように見えるかという観点も重視しています。
正直に申し上げますと、決して精度が分類タスクとしては高いわけではありません。キャラクターモデルにもよるのですが、各母音のBlendshapeの中で比較的形状が似ている組み合わせがあったりします。それぞれ個別に形状が作られていながらもそれが一般的な話し言葉のように高速で口形が変化する状況下においてその区別をするのが非常に難しいという事情があります。またパラメータの大きさによっては異なるBlendshape間で相互に類似する形状が存在したりもします。こうした事情によって、実際の定量評価結果よりも視聴した際の認知では幾分自然にみえやすい場合も考えられます。
続いて処理負荷についてです。
当社のライブコンテンツでは多いと10人以上のタレントが同時に出演する場合があります。人数が増えても、その他の描画など処理に対して影響を与えないように、並列処理をする必要があります。この点においてもTCNは非常に優秀でした。CPU上で並列処理しても、顕著な性能低下は確認されませんでした。実際のところTCNの推論実行時間よりも音声バッファからの特徴量抽出に所用する時間の方が影響が出てしまっていました。1回の推論処理については並列処理させた場合でも10msを超えないように計算量の削減や最適化を実施して気をつけています。また実際には音声の入力遅延・フィルタリング・描画の処理が入るため、配信上ではこれよりも大きな遅延がある状態でみなさんの元へ映像が届いています。
タレントの皆さんの志向や現場のニーズに応じて、いくつか調整可能なパラメータが用意されています。感度であったり、口の変形に際する滑らかさなどが設定されます。例えば滑らかさについては、早い音素の切り替えに対応しづらくなる分、過敏に口が変形しすぎることを抑制するために調整します。総じて、偽陽性への対処傾向や遅延と精度のバランスについてはポスト処理として取り扱っています。
運用
導入まで
ここまでの機械学習の基礎となる作業自体は1ヶ月程度でほぼ落ち着きました。従来手法との比較をしていきつつ、当社のアプリで運用できるよう接続・組み込みを行っていきます。検証中の不具合や事故に容易に対応できるよう、従来手法との切り替えをすぐにできる設計を維持しつつも、追加のインタフェースを作ることで今回設計した細かなパラメータ調整を行えるようにします。その後は負荷検証とQA(Quality Assurance)を行い、導入判断を現場メンバーによって行いました。負荷検証はユニット出演などの複数人での同時利用を想定し、5〜10人分の音声を入力してリップシンクを動作させます。また多くのパーティクルなどが含まれる演出時などでより描画の負荷が増えた場合も想定しながらフレームレートの低下や品質の低下などが見られないか確認します。クオリティ面については、男女のリアルタイムの音声入力の他、特に課題として大きかった歌唱について重点的に従来手法と比較しながら検証します。最後に連続稼働に関して問題ないか検証し、マニュアル作成・共有の後、現場で利用されることとなりました。
実施例
平場の喋りについては、従来手法でも一定の品質は達成できていたので、なかなか違いに気がつきにくいかもしれません。それでもクリティカルに反応しないなどのことは少なくなり、平均的な品質が向上しているかと考えています。
それでは歌唱シーンを中心に導入時の映像をみてみましょう。
具体的な例としては、下記の引用を見てもらえるとわかりやすいです!
「サクラカゼ」より「わかってるから」
従来手法(リンクより):【 3D LIVE 】ゲスト多数!新衣装お披露目&告知あり! #さくらみこ生誕祭 Birthday Party 2023 🎂 【ホロライブ/さくらみこ】
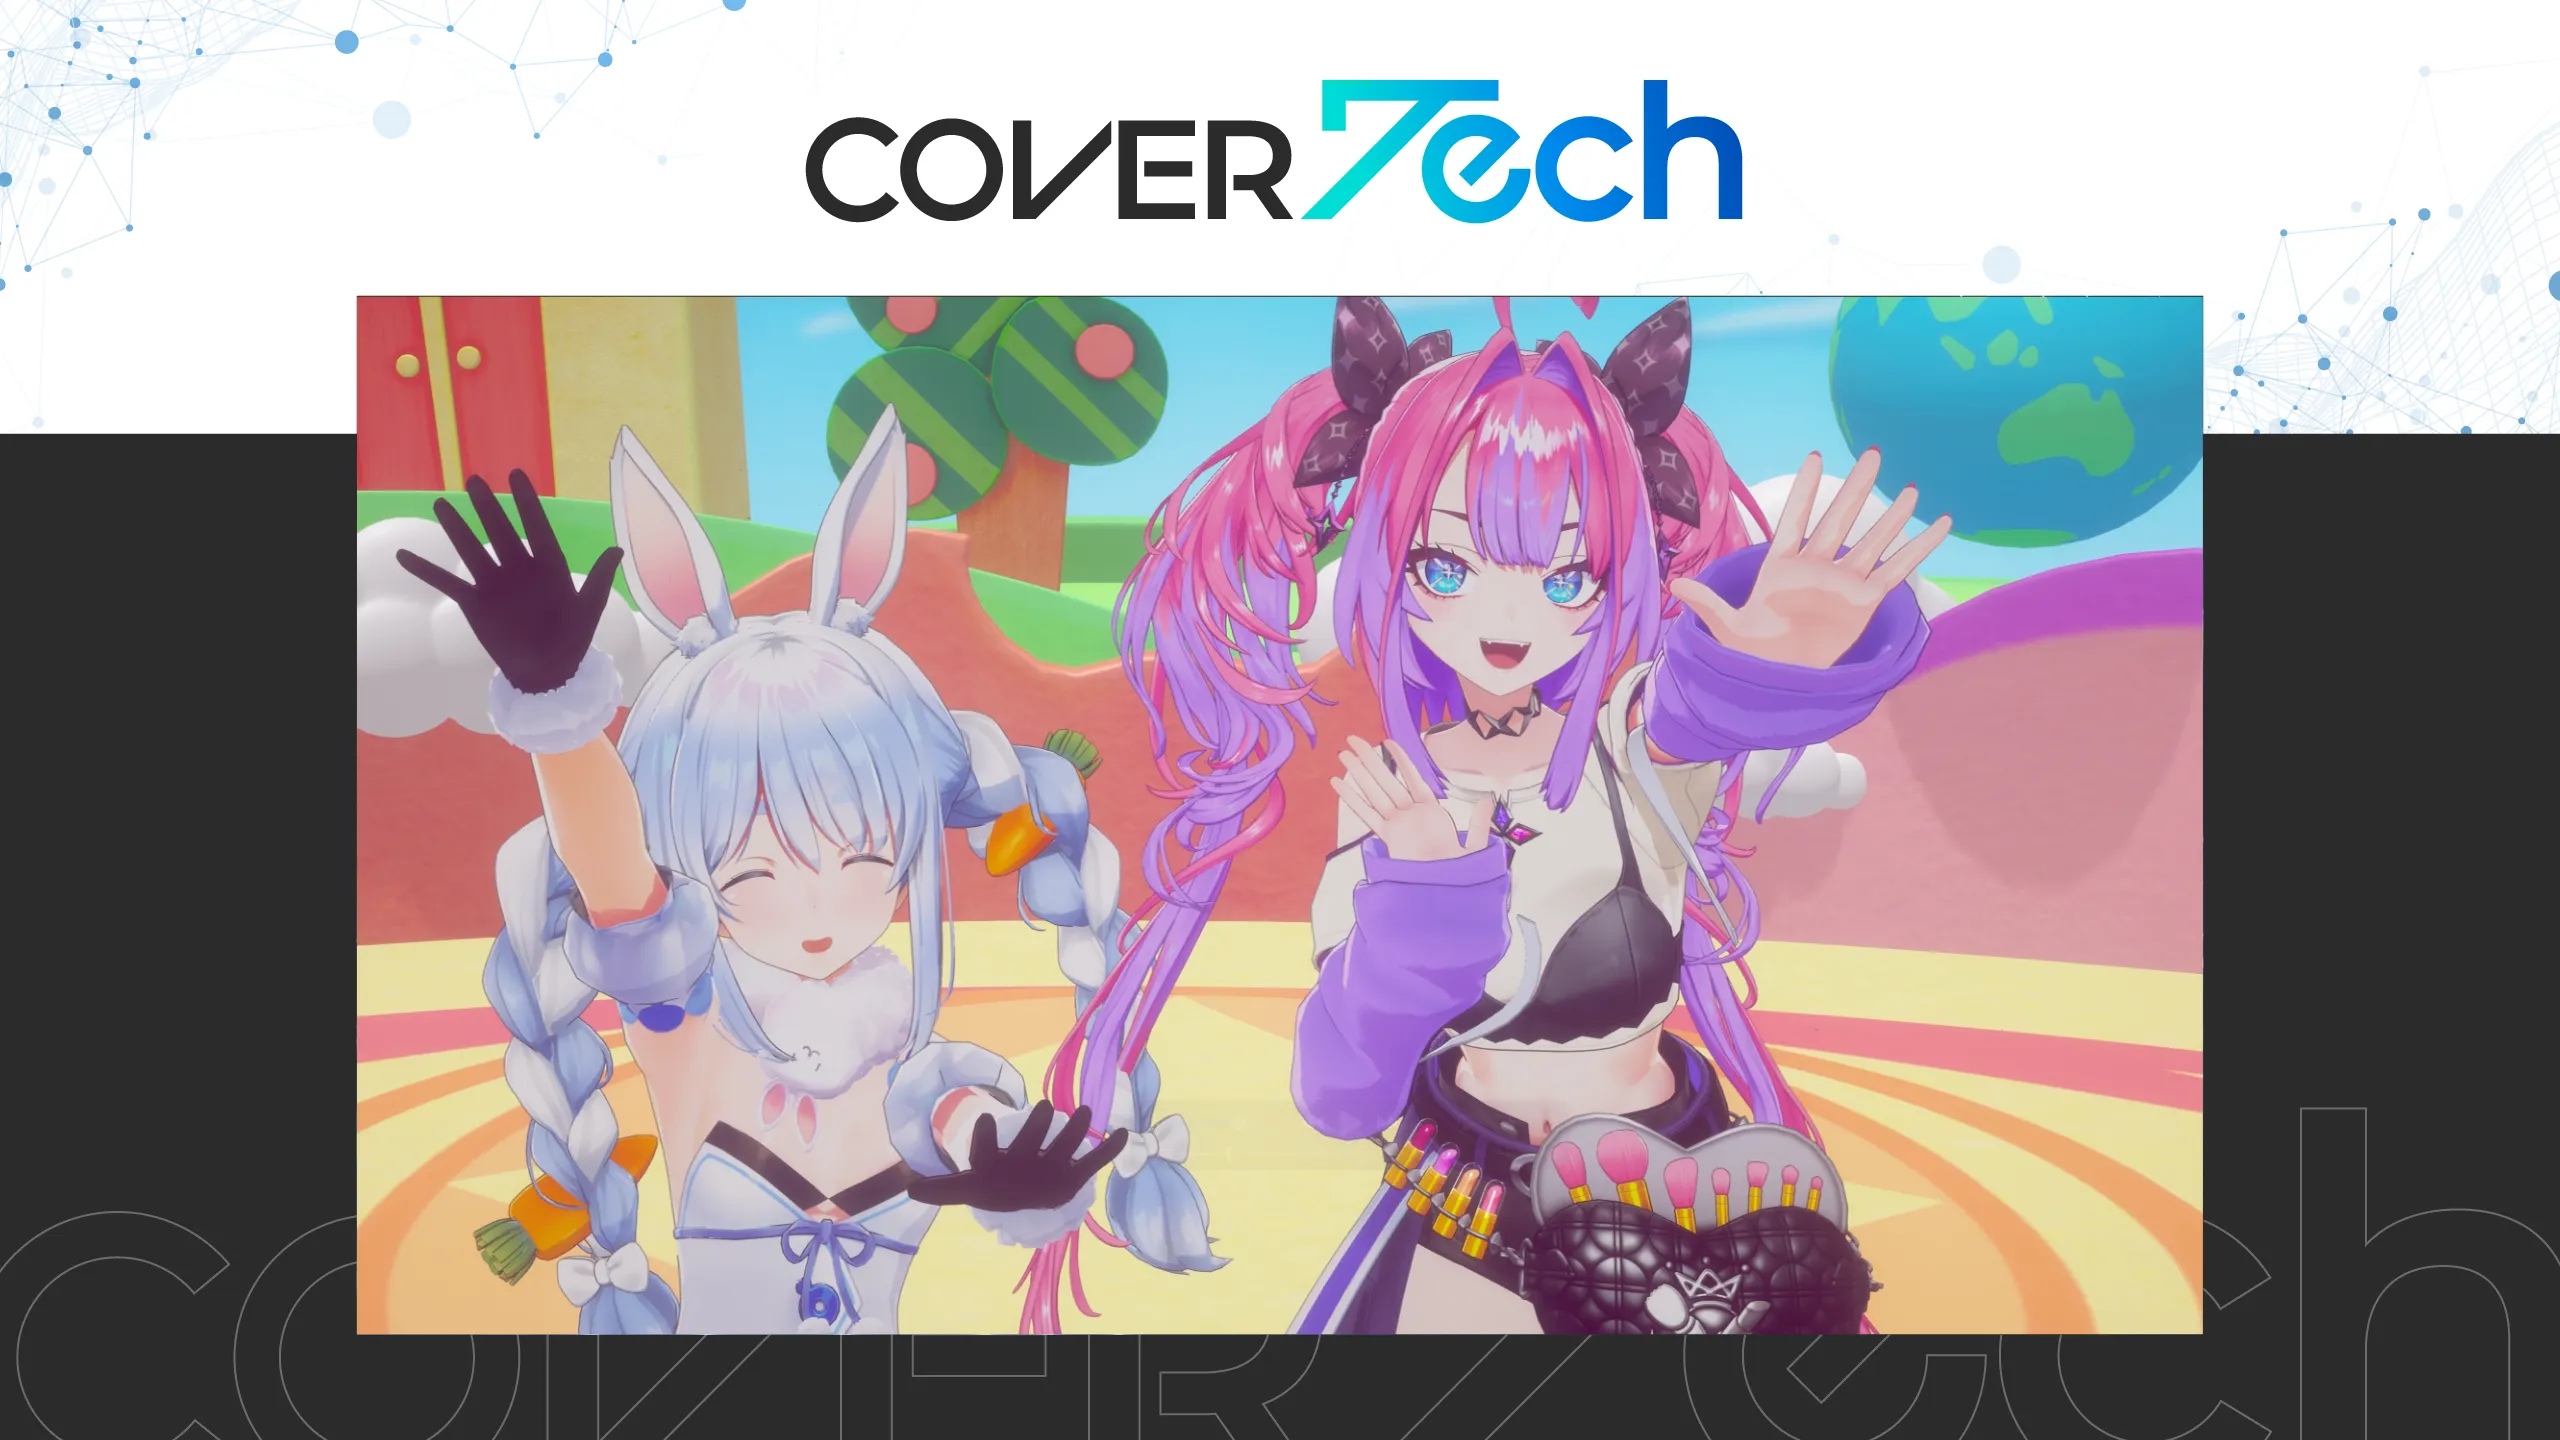
新リップシンク(図4):【3D LIVE】Ray of Jewelry【#ホロ0期生ライブ2024】

従来は、ロングトーンが全く認識できなかったり、それ以外の箇所でも反応しない場面が見受けられました。今回の改善後は、稀に異なる口形として認識されることはあるものの、まったく認識されないケースは大幅に抑えられています。ロングトーンなどフレーズ終わりにカメラが寄りたいような場面でも、問題なく反応してくれるようになりました。従来はこのような大切なタイミングでも、声は発声されているのに口が完全に閉じてしまっているところをカメラが抑えてしまうことがありました。
このようにして、単純に映像品質の向上のみならず、演出の幅が広がることに期待ができる結果を得ることができました。
課題と改善
本システムについて、品質の面において理想的なパフォーマンスが発揮できない場合があります。タレントさんの声質によっては特定の音素が認識しづらく、残念な気持ちにさせてしまったこともあります。また連続する音素の認識結果によっては、口の形が激しく高速に切り替わり、違和感がでてしまうこともあります。
これは軽量なモデルを利用していることによる表現力の不足や、データセットの偏りの影響などがあります。
それでも従来までのシステムよりは全体的な品質は向上しており、また自社で必要なチューニングを行うことができるようになった点において、内製化したメリットがあります。
この記事で紹介した実装は主に開発と展開当初の内容に基づいています。2026年3月頃に大幅な改修を行いました。最新のものについては、一部異なる設計や音響特徴が用いられており、現在も継続的な改良に取り組んでいます(図5)。また、ASIOにも対応し、さらなる遅延や運用改善についても取り組んでいます。
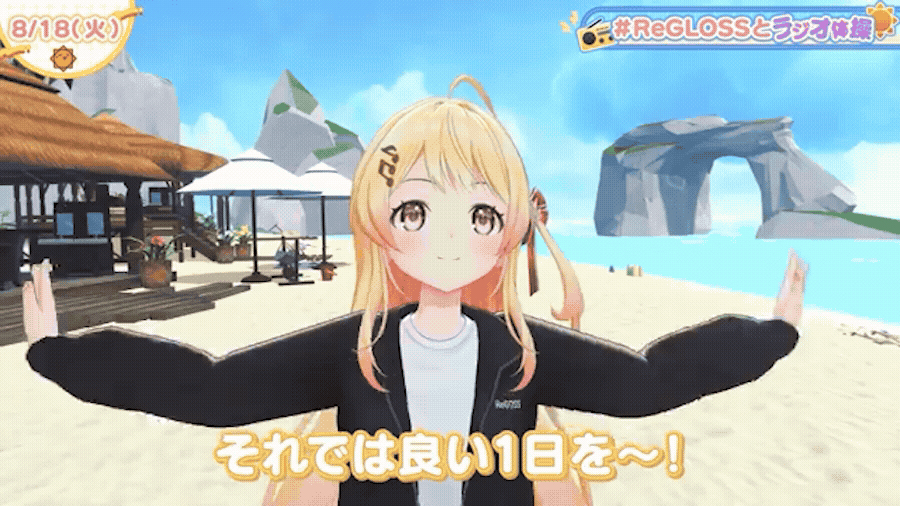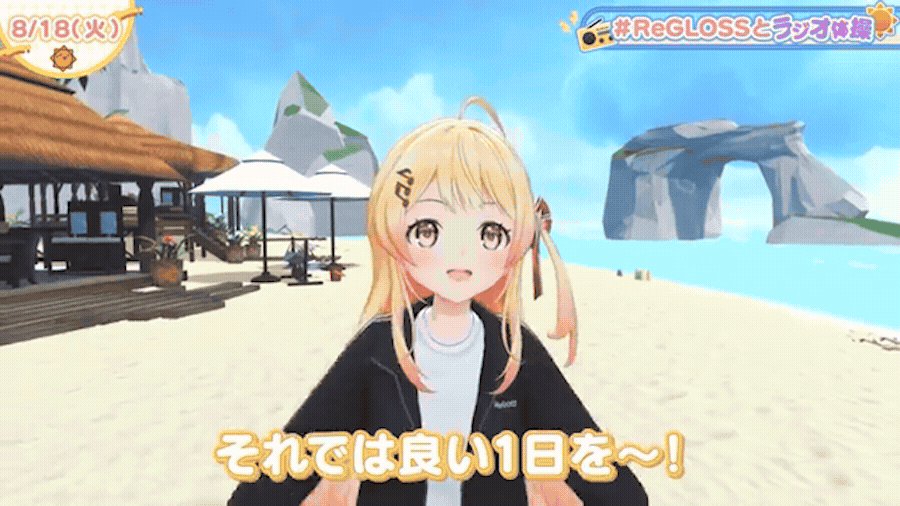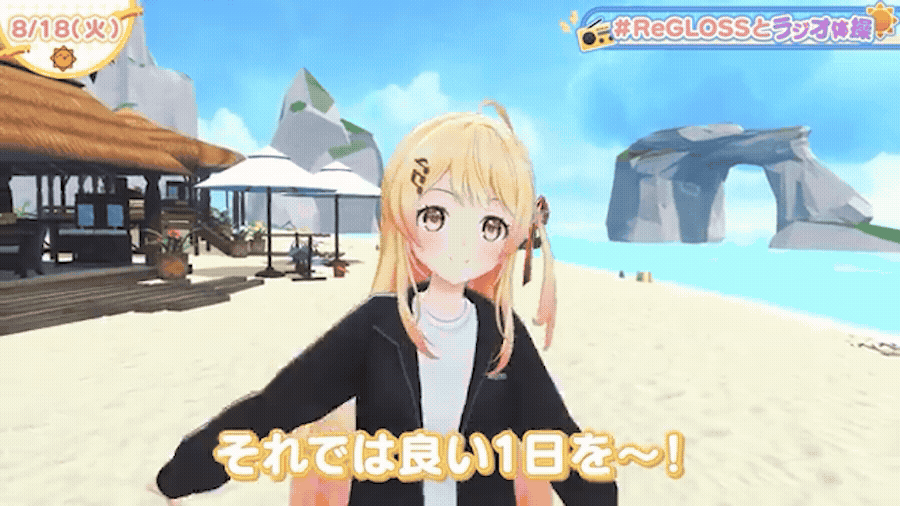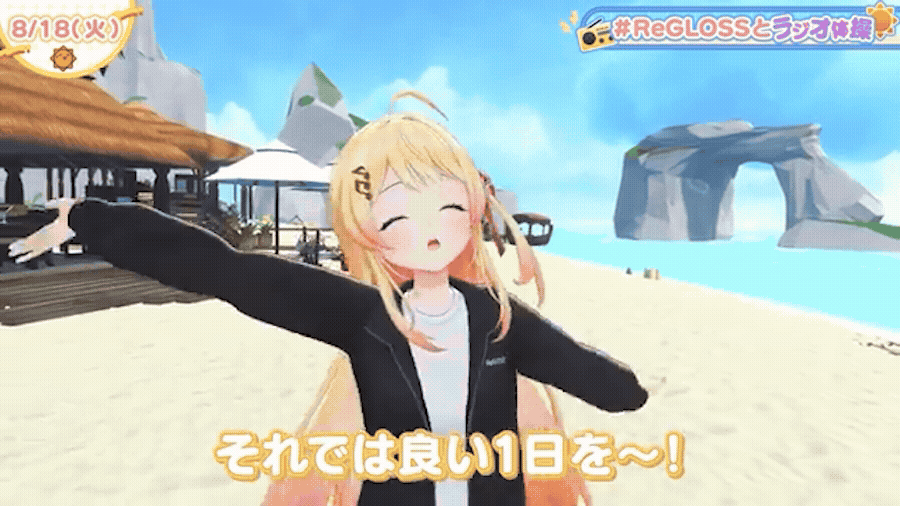
【#ReGLOSSとラジオ体操】奏と一緒にラジオ体操やりませんか?18日目
感情を聴く
「音声による表情制御」という観点で、もう一つだけ関連する取り組みを紹介させてください。
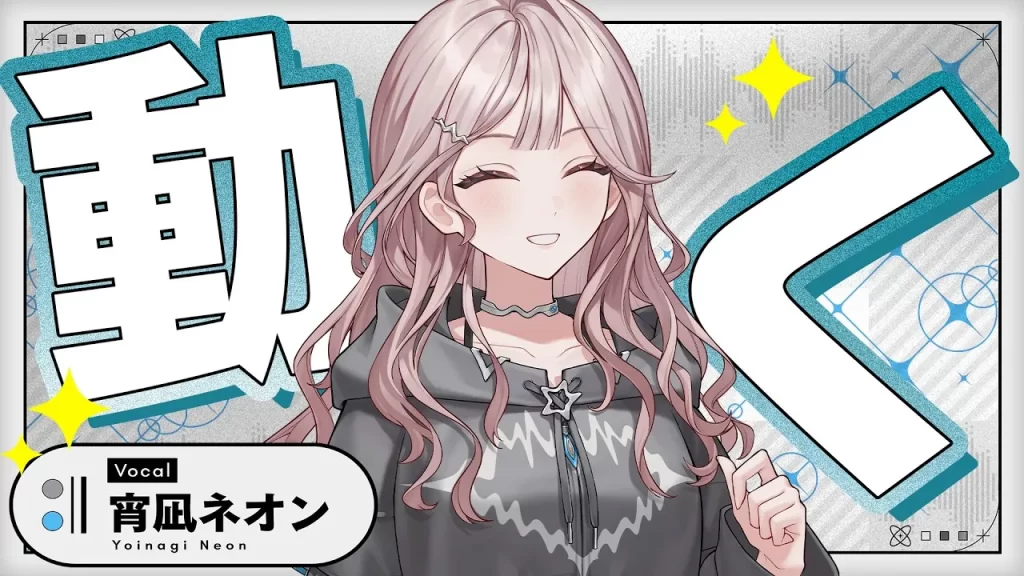
【革命】新システム記念歌枠❣❣【 #UNIT_B / #宵凪ネオン】
こちらのサムネイルに見覚えはありますでしょうか。
弊社が運営するmekParkですが、2026年6月24日より「動く」ようになりました(図6)。
また、holoANも2025年から立ち絵・静止画を中心に活動してきましたが、同時期より「動く」ようになりました。
複数のイラストを切り替えながら表現を行う手法自体は、昔からあるものではありますが、こちらの取り組みはその切り替えを自動的に制御する部分に技術的特徴があるといえます。ここにも、この記事で言及してきた「リップシンク」および「音声による表情制御」技術が用いられています。
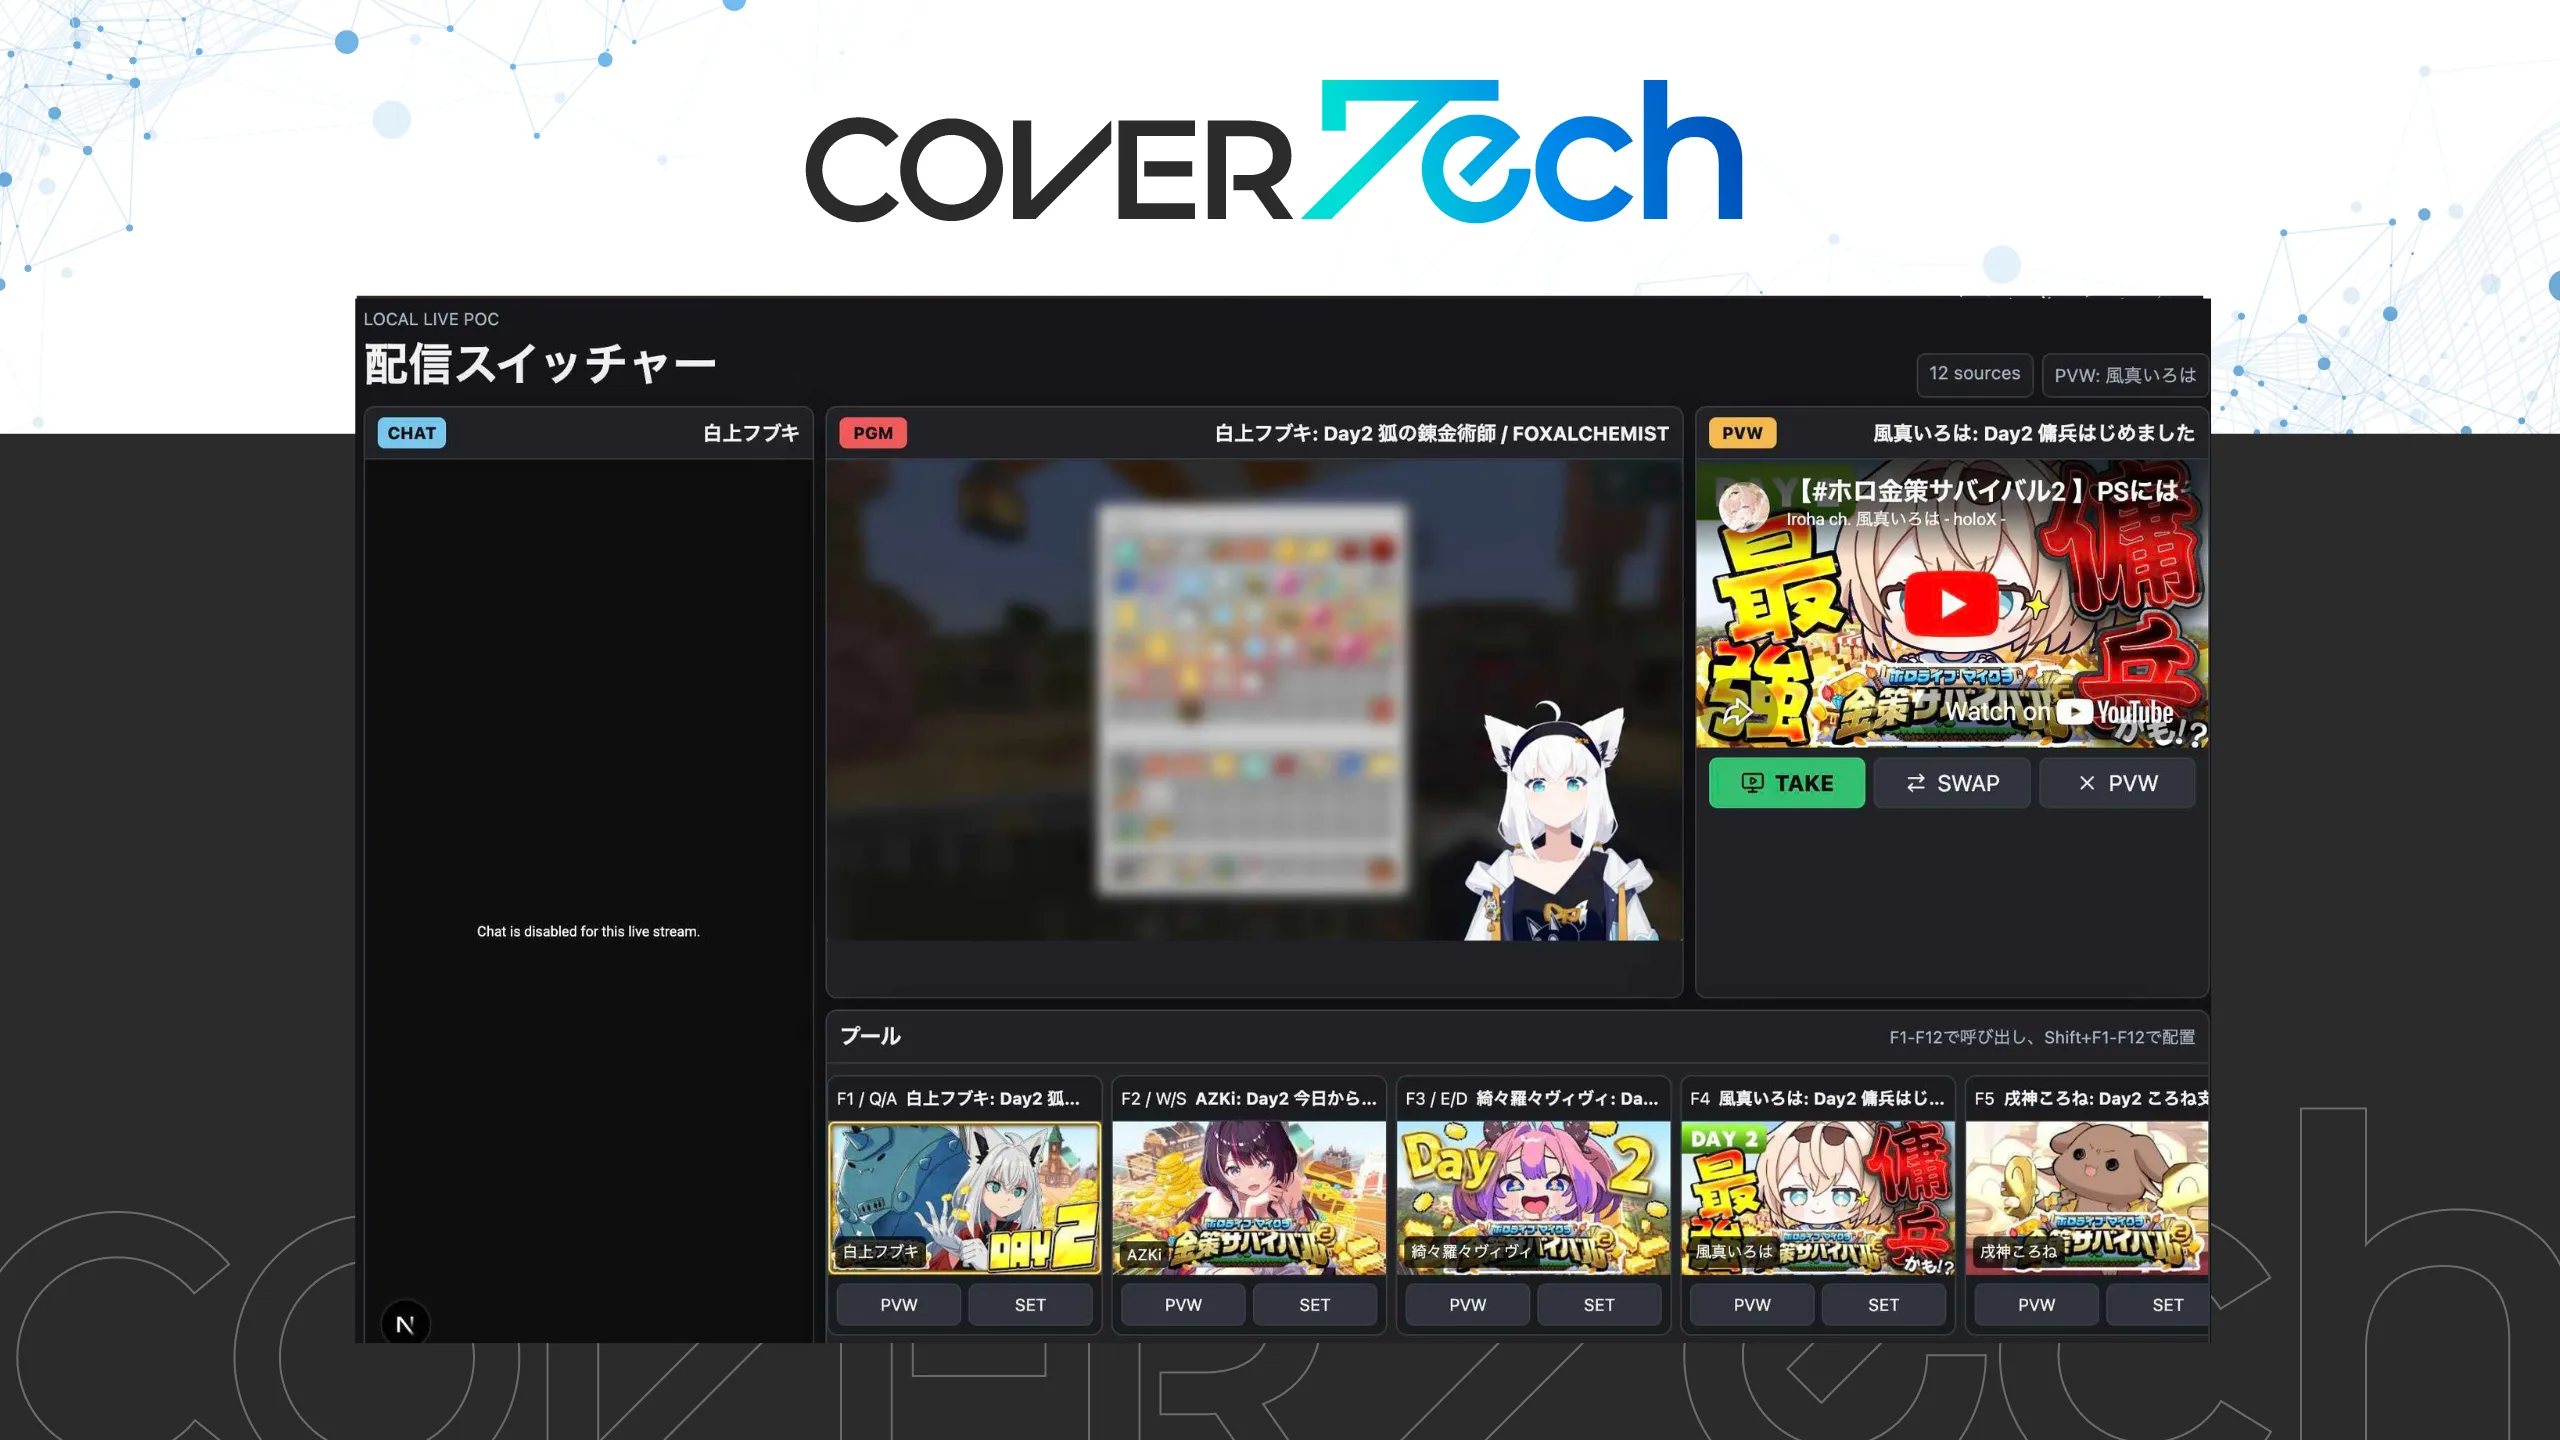
リップシンクについては、前述した内製技術と共通な内容となるのですが、mekPark・holoANで用いられている配信システムには加えて音声の特徴から、表情制御に用いる感情表現を推定する「音声感情認識」技術が実装されています(図7)。
なお、ここでいう「感情認識」は話者本人の内面的な感情を判定するものではなく、音声に現れる韻律などの特徴をもとに、表情制御のためのカテゴリを推定するものです。また、現段階ではmekPark・holoANの配信アプリにのみ実装されている機能であり、ホロライブ所属タレントが使用するアプリやライブ等で利用されている技術ではありません。
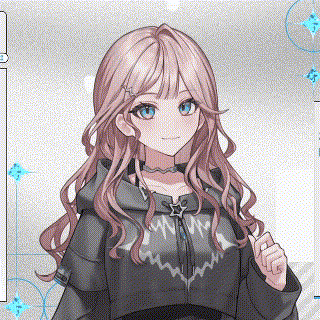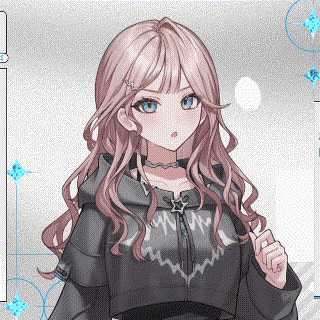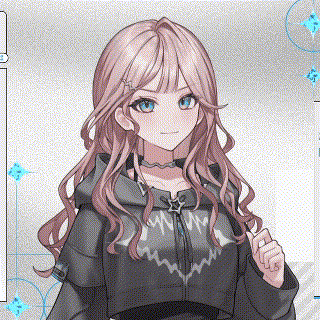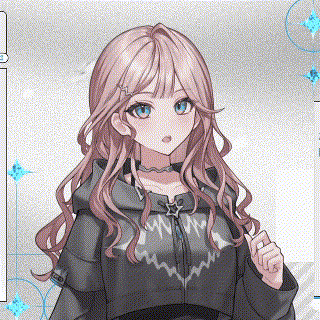
【革命】新システム記念歌枠❣❣【 #UNIT_B / #宵凪ネオン】
要素技術
具体的には、音声認識、音声感情認識、音響イベント分類の複合処理が行われています。
直近の1.5sの音声を元に音声感情認識をかけ、それを0.5s間隔で推論を実施します。そして直近5回(5ウィンドウ分の推論)の確率ベクトルを平均し、表情制御に使用する感情カテゴリを決定する実装です。また、笑いの検知には同じ音声情報をもとに音響イベント分類を行い、その出力確率に多段階の閾値制御を適用することで、表情の発生や持続を制御しています(図8)。
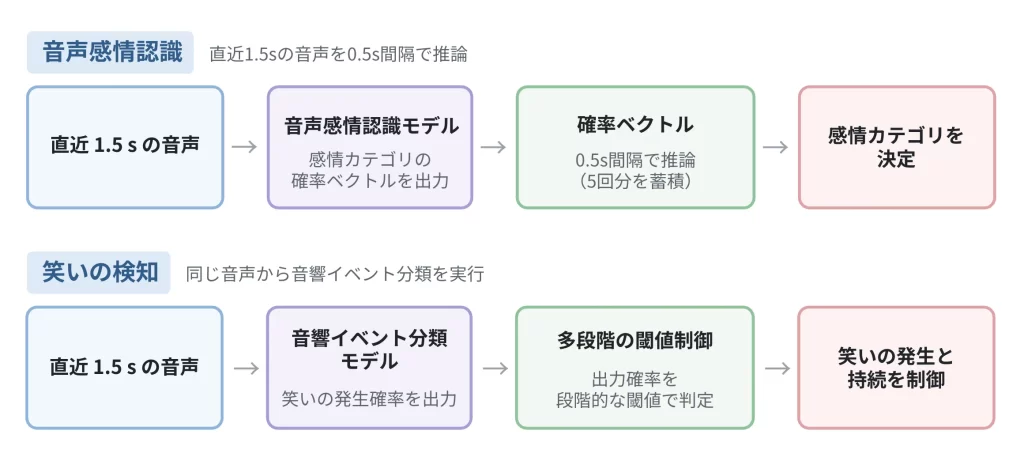
音声感情認識と笑い検知の2系統を、同じマイク入力から並行して実行します。
音声の入力情報として1.5sのデータを使うと記述しましたが、この幅から想像できるように、遅延がリップシンクと比較すると大きくなってしまいます。これはリップシンクは「音素」単位での推論なのに対し、感情は音素単位と同等な持続幅からは推論することが難しいためです。リップシンクで扱うような100ms程度の短い音声区間だけから、配信上の表情制御に利用できるほど安定した感情表現を推定することは容易ではありません。配信で観測できる表情変化の微妙な遅延はこのためであり、音声のみを用いる場合、推定にある程度の時間幅が必要になるため、リップシンクと同程度まで遅延を抑えることは難しくなります。現在採用している1.5sという時間幅も比較的短く設定しており、遅延と精度のバランスを実験的に確認した結果に基づく設計となっています。なお「イヒヒ」などの「笑い検知」については音響イベント分類として感情とは別に検出を行います。ここで入力される音声情報は共通のものです。
音声に基づく感情認識において、もう一点難しい要素があります。音声特徴には話者ごとの差があるため、同じモデルを用いても、出力されるカテゴリの傾向には個人差が生じます。
理想的には話者ごとに最適化する方法も考えられますが、運用上の負荷も大きくなります。そのため現在は、利用者自身がカテゴリごとの補正値を設定できる仕組みを採用しています。モデルの出力確率に補正を加えることで、本人が意図する表情変化に近づけられるようにしています。
ホロライブプロダクションの事情でいいますと、過去の記事等でも言及されている通り、カメラ(iPhone)を用いてフェイスキャプチャをすることが多いです。カメラベースであれば、ここで議論してきた遅延はほとんど気になることはありません。しかしながら、mekParkは5月より、カメラ等の追加デバイスを用いることなく活動してきた事情があります。新規の機材調達やセットアップをお願いすることなく、従来通りの環境でそのままマイク一本で表現を実現できるアプローチとなっています。
システムの応用
このmekParkで活用されているシステムですが「任意のイラストをベースに配信する」ということに対して、大きくハードルを下げる可能性があります。複雑な追加作業を伴うことなく、目パチや口パク等の簡単な動きが含まれる形で実現できるようになります。
例えば、先日行われました由比河ひなみさんの生誕配信では、実際に応用事例がありました(図9)。

【#由比河ひなみ生誕祭2026】誕生日、屋上で待っています。【#由比河ひなみ】#ACHRORA
普段の配信で使われているイラストについては、本システムを最大限活かせるように差分を通常よりも多く作成していますが、必ずしもすべてが必要なわけではありません。
他の用途で作成していたイラストであっても、それを配信で使える動くアバターにすることができます。
シンプルな仕組みではありますが、少し動きが入るだけでも印象は変わります。今後はホロライブ含めて、このような活用機会が増えてくるかもしれません。
おわりに
今回は、カバー株式会社の内製のリップシンク技術およびmekPark・holoANで使用している新システムについてお話しました。もちろん現時点で完璧というわけではありませんが、特に歌唱においてリップシンク品質の向上が見られ、低遅延でリアルタイムに利用できる仕組みとして実運用に載せることができました。また、カメラを用いる必要のない音声に基づく表情制御について、複数の音声認識手法を統合的に扱うことによって実現したことを示しました。
音を聞いてから数十ms〜数百msで考えて、瞬時にそれに対応する口の形へと変えるというのは人間が直接的にできるような行為ではありません。人間が達成できないようなことをAIに任せ、ライブ・配信における表現力向上に役立てた事例の紹介でした。
まだまだVTuber業界は多くの技術的課題を抱えています。現状に満足することなく、今後もカバー及び業界全体の表現力向上に繋がる研究開発を精力的に実施していく所存です。実運用の改善を進める一方で、単なる音声処理やアニメーション制御の問題ではなく、視覚的自然さや知覚品質を含む研究課題としても捉えています。
付録:音声リップシンクにおける自然さと今後の研究課題
本文では、既存の運用へ接続しやすいことを重視し、比較的単純な音素分類タスクとしてリップシンクを扱いました。しかし、口の動きの自然さを考える上では、それだけでは捉えきれない論点があります。ここでは、その背景にある研究的な視点と、今後の発展可能性について簡単に触れます。
ヒトが声を発したり、対話をする際の口元の動きについて考えてみます。実際には会話の文脈や前後の発話内容によって、発話前後にポーズが生じることが知られています [2]。このことは、口元の動きが音響信号の有無と単純に一対一対応するわけではないことを示唆します。また発話時の音は離散的ではなく、前後の文脈に応じて連続的に変動するものであるため [3]、発話は音素ごとの独立した静止口形ではないと考えられます。そのため、連続的な制御パラメータに基づいて口形を表現し、アニメーションカーブを生成するアプローチは有力であり、デジタルヒューマン/MetaHumanのようなバーチャルキャラクターを取り扱う上ではMPEG-4 FBA規格に準ずる口形素推定はその一つの実装形態といえます。
一方、アニメライクなバーチャルキャラクターにおけるリップシンクについてはどうでしょう。もちろん高い品質で、口形素を推定し、その連続的変動を含めてアニメーションに落とし込むことができれば表現として成り立ちます。しかし、リミテッドアニメーションのような日本アニメの中で築き上げてこられた表現の中では、離散的なアプローチが用いられてきており、一概に写実的であるほど望ましいとは限りません。ヒトとしての自然さとキャラクターとしての自然さは視聴者によって異なる感覚があることが想定され、どちらかが必ずしもよいとは限りません。
今回の開発は、弊社で利用されていた従来までの音声リップシンクの音素処理ロジックを改変することなく、精度を向上させるアプローチをとることを優先したために、比較的単純な音素分類タスクとしてモデルを作成しました。また現在の実装では、音声入力に対する因果的推論であるため、必ず音が先行して出力されます。しかし、現実では音を発するために口形を先に作るのが正しい関係です。長期的には、推定対象となる音素や口形の設計を見直すこと、あるいは音情報のみに依存しないフェイシャルキャプチャベースの表現を検討することも考えられます。
音をヒトが認知する上で、音そのものだけではなく、視覚的な要素も影響することが知られています [4]。したがって、自然で違和感のないリップモーションを表現することは、体験そのものにも影響することが考えられ、パフォーマンスを楽しむ上では重要な要素となります。
今回の開発では、既存の運用やリアルタイム性との両立を優先し、まずは実用上効果の高い構成を採用しました。一方で、より自然なリップシンクを考える上では、離散的な分類だけでは十分でない可能性もあります。今後は実運用での改善を継続しながら、こうした研究的な論点についても検討を深めていきたいと考えています。
参考文献
[1] 音響特徴量「メルスペクトル」と「MFCC(メル周波数ケプストラム係数)」の解説と実例紹介
[2] Ferreira 1991, Effects of length and syntactic complexity on initiation times for prepared utterances, Journal of Memory and Language 30:210–233
[3] Öhman, S. E. G. (1966). Coarticulation in VCV utterances: spectrographic measurements. JASA.
[4] MCGURK, H., MACDONALD, J. Hearing lips and seeing voices. Nature 264, 746–748 (1976). https://doi.org/10.1038/264746a0